 何昌全博客
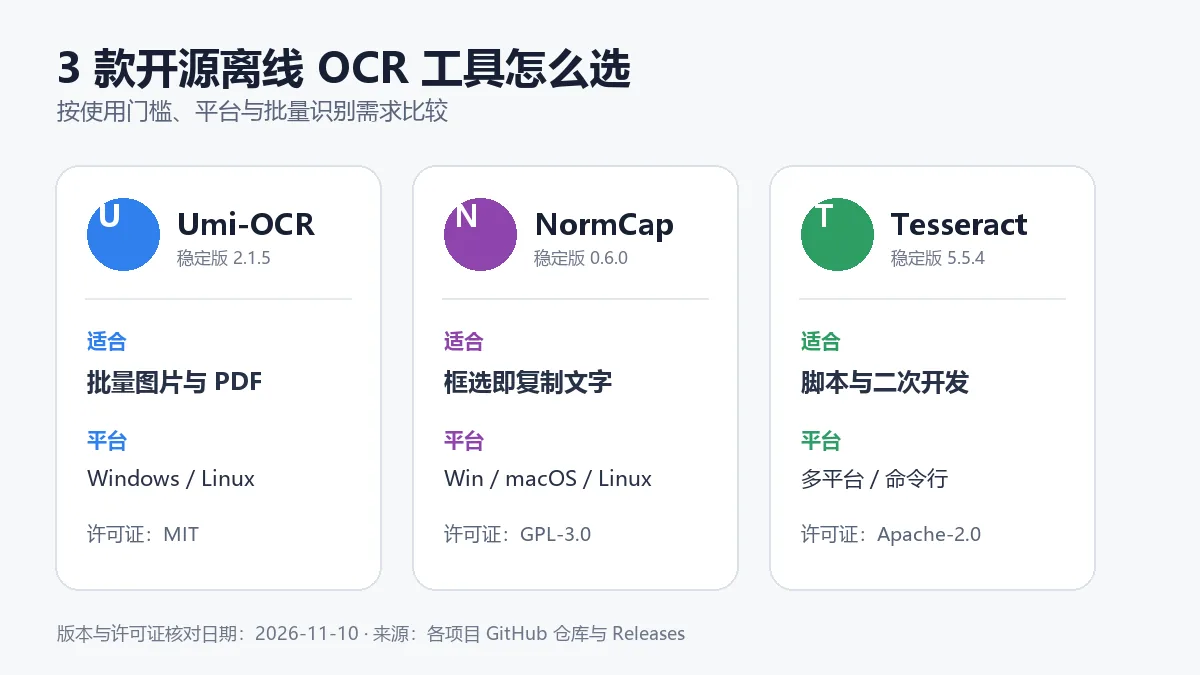
离线 OCR 的优势是图片不必上传到第三方服务器,适合处理工作文档、扫描件和包含个人信息的截图。Umi-OCR、NormCap 与 Tesseract 都是开源项目,但定位差异很大:一个偏桌面批处理,一个偏随手截屏识字,一个更像可嵌入脚本的识别引擎。
先看结论:三款工具分别适合谁
| 工具 | 更适合 | 平台 | 主要特点 |
|---|---|---|---|
| Umi-OCR 2.1.5 | 批量图片、PDF 与普通桌面用户 | Windows、Linux | 图形界面完整,内置多种识别任务 |
| NormCap 0.6.0 | 频繁从屏幕复制少量文字 | Windows、macOS、Linux | 像截图工具一样框选后直接得到文字 |
| Tesseract 5.5.4 | 开发者、自动化与大量可定制任务 | 跨平台 | 命令行与程序库,生态成熟 |
如果只想安装后马上使用,优先 Umi-OCR;如果需求是“看到文字就框一下复制”,NormCap 更顺手;如果要写脚本、接入程序或精细控制语言和版面,Tesseract 更合适。
Umi-OCR:最适合批量文件和桌面使用
Umi-OCR 是 MIT 许可证开源工具,官方仓库提供 Windows 与 Linux 版本。它支持截图识别、批量图片、PDF、多栏排版等任务,并将识别过程保留在本地。2.1.5 是当前官方 Releases 可见的稳定版本。
优点
- 不需要命令行,导入文件即可操作;
- 批量任务和结果导出比纯截图工具完整;
- Windows 包提供 Rapid 与 Paddle 等不同方案,可按 CPU 兼容性选择。
限制
安装包和模型体积相对更大;老旧 CPU 需要留意指令集兼容性。处理复杂表格、手写体或严重倾斜的扫描件时,仍应抽查识别结果。
NormCap:最快的屏幕文字复制方式
NormCap 的操作逻辑类似区域截图:启动后框选屏幕上的文字,识别结果进入剪贴板。项目使用 GPL-3.0 许可证,Windows、macOS 和 Linux 均有支持,底层使用 Tesseract。
优点
- 步骤少,适合网页、软件界面和图片中的短文本;
- 可识别段落,也能使用按行解析模式;
- 本地处理,不必把截图上传在线 OCR。
限制
它不是扫描件管理工具,不适合一次处理大量 PDF。macOS 用户还要授予屏幕录制权限,官方仓库也提醒应用可能没有 Apple 签名,应只从项目 Releases 或推荐渠道下载。
Tesseract:自动化能力最强,但需要配置
Tesseract 是 Apache-2.0 许可证的 OCR 引擎,可以通过命令行运行,也能被其他软件调用。5.5.4 于 2026 年 10 月发布,官方说明包含多项安全修复,因此已有旧版部署应评估升级。
它适合服务器批处理、脚本工作流和开发集成,但上游项目不直接提供官方 Windows 安装包,Windows 用户通常需要使用文档列出的第三方构建。下载时应核对来源和签名,不要从不明软件下载站获取。
使用前要准备什么
- 安装对应语言数据,例如简体中文与英文;
- 根据单栏、稀疏文字或多栏页面选择页面分割模式;
- 先做裁切、旋转、去噪和对比度处理,提高扫描件准确率。
按场景选择更实际
截图、聊天记录与软件报错
NormCap 操作最快。如果还需要录屏或完整截图工作流,可结合本站的ShareX 功能介绍比较。
扫描 PDF 与批量图片
优先 Umi-OCR。若还需要查看、批注和整理 PDF,可参考3 款开源 PDF 工具对比,再把 OCR 与阅读工具分工使用。
自动归档与开发项目
优先 Tesseract。先用少量真实样本测试语言、版面和准确率,再扩展到批量任务;不要只用一张清晰图片判断整体效果。
隐私与准确率提醒
“离线”只代表识别不依赖云端,并不自动保证整个电脑安全。安装包必须来自官方仓库,输出文本和临时截图也要按原文档敏感级别保存。OCR 对金额、日期、序列号和身份证件字段尤其容易产生难以察觉的错误,正式使用前应人工复核关键数据。
版本与来源
本文核对时间为 2026 年 11 月 10 日(日本时间):Umi-OCR 2.1.5、NormCap 0.6.0、Tesseract 5.5.4。版本信息均来自项目官方 GitHub 仓库和 Releases 页面。