 何昌全博客
在生成式AI极其狂飙的时代,文本生成视频(Text-to-Video)与图生视频(Image-to-Video)已被视为视觉创作的下一代工业革命。
然而,当前的AI视频赛道正面临着极其严重的“闭源商业垄断”。无论是至今仍对公众大门紧闭的OpenAI Sora,还是按帧收费、动辄消耗海量订阅积分的Runway Gen-3与Pika,都将极客与独立创作者死死困在云端付费墙外。更致命的是,将极其私密的商业设计图或未公开的影视脚本上传至这些云端API,无异于将核心资产底牌和盘托出。
真正的极客绝不接受算力与创意的双重绑架。依托庞大的开源社区,目前底层架构完全开源、且支持利用本地显卡(GPU)进行私有化离线渲染的AI视频大模型已迎来技术爆发。今天何昌全博客为你盘点3款当前GitHub上最硬核的开源AI视频底座,带你彻底夺回视频生成的算力主权。
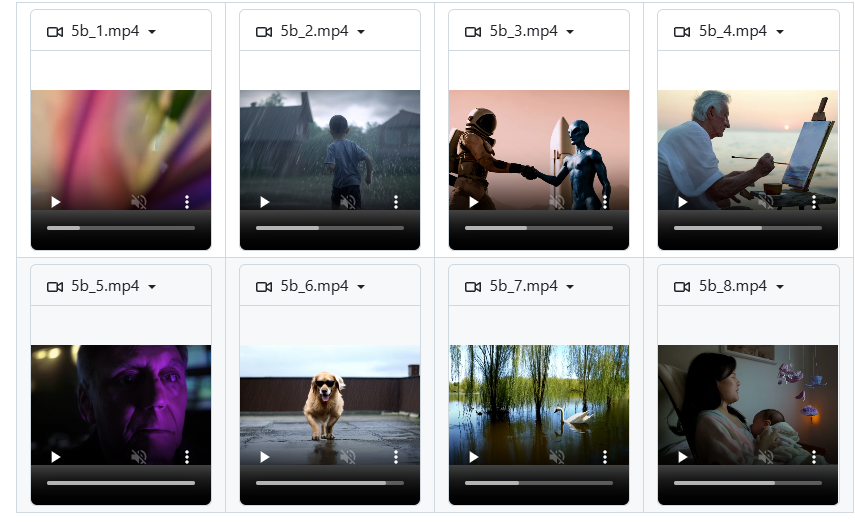
1.CogVideoX(智谱AI):当前开源界极其硬核的文生视频(T2V)霸主
如果你需要一个能直接在本地消费级显卡上跑起来,且对中文提示词理解极其精准、物理运动规律极度逼近Sora的文本生成视频模型,这款由清华技术班底开源的底层重炮是绝对的天花板。
-
核心极客优势:
-
极其变态的三维变分自编码器(3D VAE)架构:它在底层将视频数据的时间与空间维度进行了极其高倍率的无损压缩。这意味着它不需要动辄企业级的A100算力集群,极客利用手头极其常见的单张RTX3060或RTX4090显卡,配合量化技术,就能在本地极其丝滑地生成高动态连贯视频。
-
深度优化的专家级文本编码器:原生内置极其强悍的中文与长文本语义解析能力。你不需要去写极其晦涩的机器提示词,直接输入极其口语化且包含复杂运镜指令的脚本,它就能精准还原镜头平移、物理碰撞与光影变化。
-
2.Open-Sora:完全开源的DiT架构Sora复刻工程
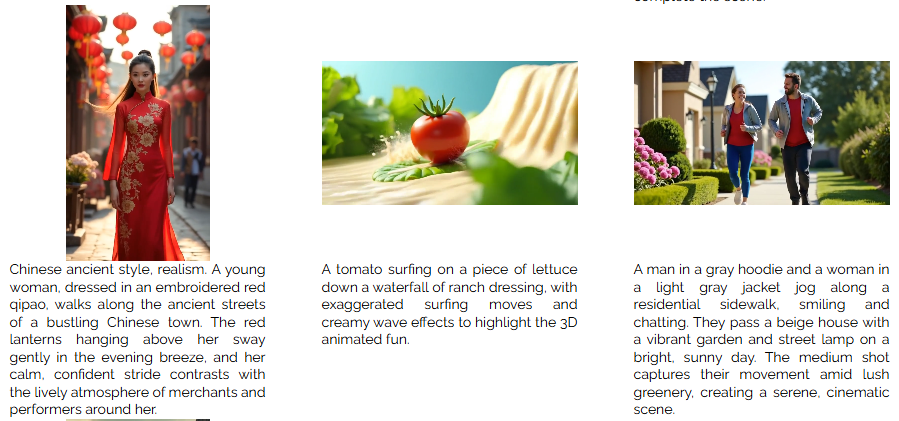
如果你是一名痴迷于底层架构研究的硬核开发者,渴望亲自剖析Sora背后的Diffusion Transformer(DiT)底层算法原理并自行微调(Fine-tuning),这个由Colossal-AI团队主导的开源复刻项目将为你提供全套源码。
-
核心极客优势:
-
全链路开源的透明化工程:它不仅开源了模型权重,更极其无私地放出了从数据处理、底层训练代码到推理加速的全套开源流水线。它是极客深入理解下一代视频生成底层逻辑的终极教科书。
-
极其强悍的多分辨率与多时长控制:其底层架构支持动态分辨率与极其灵活的视频时长生成。配合其社区提供的强大加速引擎,可以在本地环境大幅降低训练与推理的显存开销成本,极其适合中小团队基于自身垂直业务数据进行私有化二次训练。
-
3.Stable Video Diffusion(SVD):生态极其繁荣的图生视频(I2V)核武
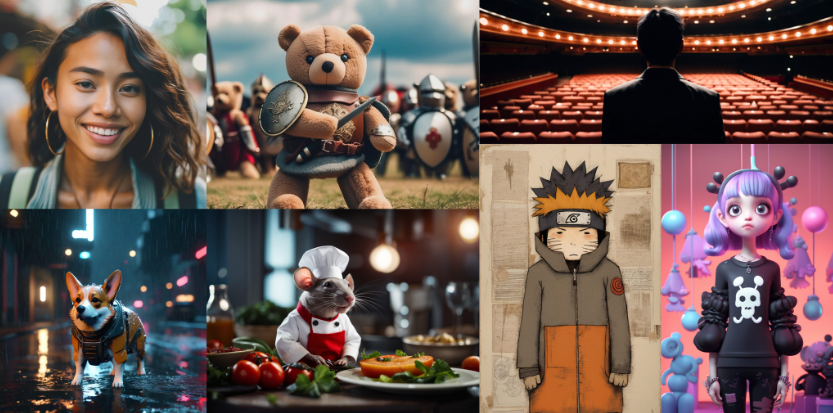
在进行AI短片制作时,我们往往需要先用Midjourney或Stable Diffusion生成极其完美的静态分镜图,再让其“动”起来。在这条图生视频的底层赛道上,Stability AI官方开源的SVD是无可争议的生态王牌。
-
核心极客优势:
-
极致的静态图激活渲染:相比于直接由文本生成视频的不可控性,SVD极其擅长将极客输入的静态主视觉图转化为拥有极其顺滑运镜与流体动态的高清短片,是制作赛博朋克动画、游戏概念PV的绝对利器。
-
极其变态的ComfyUI节点生态集成:这是它最让极客疯狂的底牌。在极度硬核的节点式UI界面(ComfyUI)中,你可以将SVD模块与各类ControlNet、重绘节点进行极其复杂的连线组合。实现精准控制视频中特定人物的动作走向、甚至控制画面的光影流转,这是任何闭源傻瓜式云端工具都无法企及的底层操作自由度。
-
如何构建你本地的AI视频渲染工作站?
对于追求绝对控制权的极客而言,闭源商业API只适合极其浅尝辄止的试玩。
要在本地彻底打通这套开源AI视频流水线,你只需在电脑上极速部署 ComfyUI 或 WebUI 等开源图形框架,将上述三大模型的权重文件(Checkpoints)下载至本地硬盘即可开箱即用。无论外面商业大模型如何封号、限流或涨价,你本地硬盘里由纯粹代码构筑的AI渲染引擎,将永远无条件为你每一帧的创意疯狂燃烧算力。